本书作者:测试开发刚哥,文章版权归个人所有,未经授权请勿转载。
编解码器
在字符与字节之间的转换过程称为编解码,Python 自带了超过 100 种编解码器,比如:
- ascii(英文体系)
- gb2312(中文体系)
- utf-8(全球通用)
- latin1
- utf-16
编解码器一般有多个别名,比如
utf8、utf-8、U8。
这些编解码器可以传给 open()、str.encode()、bytes.decode()等函数的 encoding 参数。
UnicodeEncodeError
多数非 UTF 编解码器(比如 cp437)只能处理 Unicode 字符的一小部分子集。把字符转换成字节时,如果目标编码中没有定义这个字符,那么就会抛出 UnicodeEncodeError 异常。
处理方式一:使用 utf8 编码。
处理方式二:添加 errors 参数:
## 忽略 如b'So Paulo'
city.encode("cp437", errors="ignore")
## 替换为? 如b'S?o Paulo'
city.encode("cp437", errors="replace")
## 替换为XML实体 如b'São Paulo'
city.encode("cp437", errors="xmlcharrefreplace")
UnicodeDecodeError
把字节转换为字符时,遇到无法转换的字节时会抛出 UnicodeDecodeError 异常。这是因为不是每个字节都包含有效的 ASCII 字符,也不是每个字符都是有效的 UTF-8。
处理方式也有两种,跟上面一样。
SyntaxError
Python3 默认使用 UTF-8 编码源码。如果加载的.py 模块中包含 UTF-8 之外的数据,而且没有声明编码,就会抛出 SyntaxError 异常。
处理方式是在文件顶部添加 coding 注释:
## coding: cp1252
但是这个办法并不好,最好还是找到这些报错字符,把它们转换为 UTF-8。
从网上直接复制代码到 IDE 中执行经常会报这个错。
处理文本文件
Unicode 三明治:
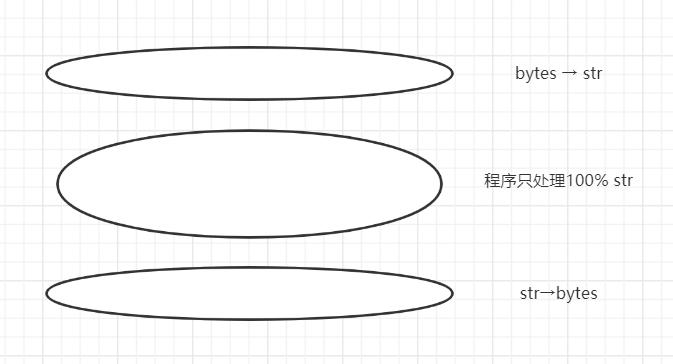
在程序中尽量少接触二进制,把字节解码为字符,只处理字符串对象。比如在 Django 中,view 应该输出 Unicode 字符串,Django 会负责把响应数据编码成字节序列,而且默认使用 UTF-8 编码。
Python 内置的 open 函数就是采用了这个原则,在读取文件时会做必要的解码,以文本模式写入文件时会做必要的编码。
文件乱码
Windows 更容易遇到这个问题,因为 Windows 并不是统一的 UTF-8 编码,比如在 Windows10 中:
>>> open("cafe.txt", "w", encoding="utf8").write("café")
4
>>> open("cafe.txt").read()
'caf茅'
写入文件时指定了 utf8,但是读取文件没有指定,Python 就会使用系统默认编码:
>>> import locale
## 打开文件用这个
## 如果没有设置PYTHONENCODING环境变量,sys.stdout/stdin/stderr也用这个
>>> locale.getpreferredencoding()
'cp936'
cp936把最后一个字节解码成了茅而不是é。
>>> import sys
# 二进制数据和字符串之间转换用这个
>>> sys.getdefaultencoding()
'utf-8'
>>> import sys # 文件名(不是文件内容)用这个 >>> sys.getfilesystemencoding() 'utf-8'
GNU/Linux 或 Mac OS X 不会遇到这个问题,因为多年来它们的默认编码都是 UTF-8。
解决办法是一定不能依赖系统默认编码,打开文件时始终应该明确传入 encoding=参数,因为不同的设备使用的默认编码可能不同,有时隔一天也会发生变化。
小结
本文介绍了 Python 的编解码器,以及可能出现的 UnicodeEncodeError、UnicodeDecodeError、SyntaxError 问题,然后给出了 Python 的 open 函数处理文本文件的原则,最后对 Windows 容易出现的文件乱码问题进行了说明。
参考资料:
《流畅的 Python》